LLM(大規模言語モデル)とは?
LLM(Large Language Model)とは、膨大な量のテキストデータを学習し、人間が書いたような自然な文章を理解・生成できるAIモデルです。日本語では「大規模言語モデル」と訳されます。
質問への回答、文章の要約や翻訳、メールの下書きなど、言葉を扱うさまざまな作業をこなせる点が特徴です。
LLMとは簡単に言うと「言葉のつながりを学んだAI」
LLMを簡単に言うと、ある言葉の次にどんな言葉が続きやすいかを大量の文章から学んだAIです。
たとえば、スマートフォンで「お疲れ」と入力すると、「様です」が候補に表示されることがあります。LLMはこの予測変換を、はるかに大規模かつ高度にしたものとイメージするとわかりやすいでしょう。
LLMは、単語単位だけでなく文章全体の文脈をふまえて「次の言葉」を予測し続けることで、質問への回答や長い文章を組み立てています。
「大規模」とは何が大きいのか
LLMの「大規模」とは、主に次の3つの規模が大きいことを指します。
|
たとえば、2020年に発表されたOpenAIの「GPT-3」は、パラメータ数が1,750億とされています。
出典:Brown et al.「Language Models are Few-Shot Learners」
一般的に、データやパラメータの規模が大きくなるほど、より複雑な文脈を理解し、自然な文章を生成できるようになるとされています。
LLMが注目されている理由
LLMが広く知られるようになったきっかけは、2022年11月にOpenAIが公開したChatGPTです。誰でも自然な言葉でAIと対話できるようになり、ビジネスでの活用が一気に広がりました。
出典:OpenAI「Introducing ChatGPT」
従来のチャットボットは、あらかじめ用意したシナリオや回答パターンに沿って応答するものが中心でした。一方、LLMは質問の意図や文脈をくみ取り、その場で文章を組み立てて回答できます。
そのため、問い合わせ対応や文書作成、情報検索など、これまで人が担っていた言葉を扱う業務を効率化できる技術として注目されています。
LLMとAI・生成AI・ChatGPTの違い
LLMは、AI・生成AI・ChatGPTといった言葉と一緒に使われることが多く、違いがわかりにくい用語です。ここでは、混同されやすい3つの用語との違いを紹介します。
AIとの違い
AI(人工知能)は、人間の知的な働きをコンピューターで再現する技術全般を指す、広い概念です。
LLMはAIの一種であり、AIのなかでも「機械学習」「ディープラーニング(深層学習)」と呼ばれる技術を使って、言葉を扱うことに特化したモデルです。
つまり、「AI」という大きな枠のなかに「LLM」が含まれる関係といえます。
生成AIとの違い
生成AIは、文章・画像・音声・動画などの新しいコンテンツを生成するAIの総称です。
LLMは、生成AIのなかでも文章(テキスト)を扱う中核の技術です。画像生成AIや音声生成AIなど、LLMとは異なる仕組みで動く生成AIもあるため、「生成AI=LLM」ではない点に注意しましょう。
なお、最近のLLMには、文章だけでなく画像や音声も扱えるマルチモーダルなモデルも増えています。
▼あわせて読みたい
ChatGPT・Copilotとの違い
ChatGPTやMicrosoft Copilotは、LLMを使って作られたサービス(アプリケーション)です。
たとえば、ChatGPTはOpenAIが開発したLLM「GPT」シリーズを使ったAIチャットサービスです。つまり、LLMはサービスの裏側で動く「エンジン」、ChatGPTやCopilotはそのエンジンを使って利用者が操作できるようにした「製品」と考えるとよいでしょう。
それぞれの違いを表にまとめると、以下のとおりです。
|
用語 |
意味 |
具体例 |
|
AI |
人間の知的な働きをコンピューターで再現する技術全般 |
画像認識、音声認識、需要予測 など |
|
生成AI |
文章・画像・音声などの新しいコンテンツを生成するAI |
文章生成AI、画像生成AI、音声生成AI |
|
LLM |
大量のテキストを学習し、文章を理解・生成するAIモデル |
GPT、Gemini、Claude、Llama |
|
ChatGPT・Copilot |
LLMを使って作られたサービス |
ChatGPT、Microsoft Copilot、Gemini(アプリ) |
チャットボットとChatGPTの違いについては、以下の記事でも詳しく解説しています。
▼あわせて読みたい

LLMの仕組み
LLMは、入力された文章を細かく分解・数値化し、文脈をふまえて次に続く言葉を予測することで文章を生成しています。ここでは、LLMが文章を生成するまでの流れを5つのステップで紹介します。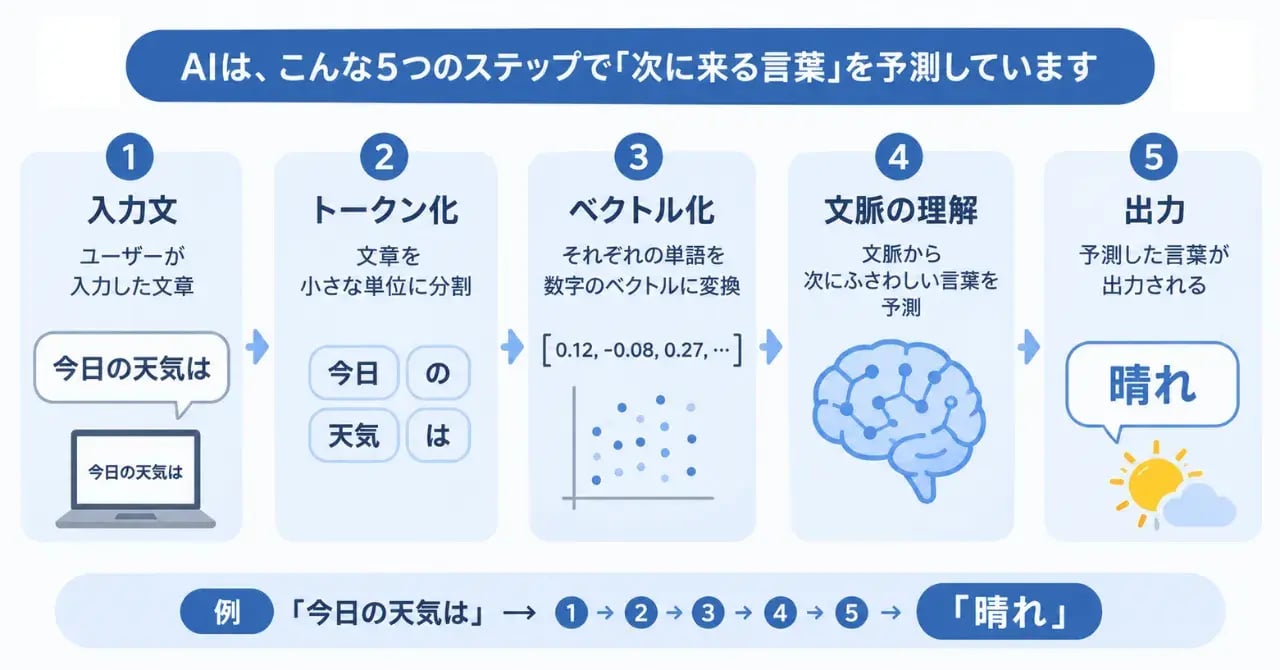
ステップ1|トークン化
まず、入力された文章を「トークン」と呼ばれる小さな単位に分割します。
トークンは単語や文字、単語の一部などで構成されます。たとえば「今日の天気は」という文章であれば、「今日」「の」「天気」「は」のように分けて処理されます。
ステップ2|ベクトル化
次に、分割したトークンを「ベクトル」と呼ばれる数値の並びに変換します。
コンピューターは言葉をそのまま理解できないため、数値に置き換えて扱います。このとき、意味が近い言葉ほど近い数値になるように変換されるため、「犬」と「猫」は近く、「犬」と「自動車」は遠い、といった言葉同士の関係を表現できます。
▼あわせて読みたい
ステップ3|文脈を理解する
ベクトルに変換した情報をもとに、文章全体の文脈を読み取ります。
多くのLLMは「Transformer(トランスフォーマー)」と呼ばれる仕組みを採用しています。Transformerの特徴は、文章のなかで「どの言葉とどの言葉が強く関係しているか」に注目して処理できる点です。この仕組みは「アテンション(注意機構)」と呼ばれます。
出典:Vaswani et al.「Attention Is All You Need」
たとえば「彼はりんごを買って、それを食べた」という文章では、「それ」が「りんご」を指していると判断できます。こうした言葉同士の関係をとらえることで、長い文章でも文脈に沿った処理が可能になります。
ステップ4|次の言葉を予測する
文脈を理解したうえで、次に続く可能性が高いトークンを予測します。
「今日の天気は」の次には「晴れ」「雨」「曇り」など、いくつかの候補が考えられます。LLMはそれぞれの候補の確率を計算し、文脈に合うものを選びます。
ステップ5|文章として出力する
選んだトークンを文章に追加し、再び次の言葉を予測します。この作業をくり返すことで、一つの文章や回答が完成します。
なお、LLMは事前学習で膨大なテキストから言葉のパターンを学んだあと、特定の用途に合わせた追加学習や、人によるフィードバックをもとにした調整を経て、質問に適切に答えられるように仕上げられています。
LLMの主な種類
LLMは、開発元や提供方法によっていくつかの種類に分けられます。ここでは、代表的なLLMと分類の考え方、性能の比べ方を紹介します。
海外の代表的なLLM
現在、ビジネスで広く使われているLLMの多くは、海外のテック企業が開発したものです。代表的なLLMとして、以下が挙げられます。
|
モデル名 |
開発元 |
主な利用サービス |
|
GPT |
OpenAI |
ChatGPT、Microsoft Copilot |
|
Gemini |
|
Gemini(アプリ)、Google Workspace |
|
Claude |
Anthropic |
Claude |
|
Llama |
Meta |
Meta AI、各社のAIサービス |
各モデルは、得意な作業や対応できる文章の長さ、料金などがそれぞれ異なります。業務で利用する際は、用途に合わせて選ぶことが大切です。
国産LLM
日本企業や研究機関が開発した国産LLMも増えています。代表的な国産LLMとして、以下が挙げられます。
|
モデル名 |
開発元 |
|
tsuzumi |
NTT |
|
LLM-jp |
国立情報学研究所(NII)を中心とする研究チーム |
|
Sarashina |
SB Intuitions(ソフトバンクグループ) |
|
cotomi |
NEC |
|
Takane |
富士通 |
国産LLMは、日本語の文章を多く学習しているため、日本語特有の言い回しや敬語の扱いに強いとされています。
また、データを国内で管理しやすいことから、セキュリティを重視する企業や行政機関での活用も期待されています。
オープンモデルとクローズドモデル
LLMは、モデルの中身を公開しているかどうかで「オープンモデル」と「クローズドモデル」に分けられます。
|
項目 |
オープンモデル |
クローズドモデル |
|
特徴 |
モデルのデータ(重み)が公開されている |
モデルは非公開で、サービスやAPI経由で利用する |
|
代表例 |
Llama、LLM-jp など |
GPT、Gemini、Claude など |
|
メリット |
自社環境で動かせる、カスタマイズの自由度が高い |
高性能なモデルをすぐに使える、運用の手間が少ない |
|
注意点 |
運用・管理を自社で担う必要がある |
入力データの扱いや利用料金を確認する必要がある |
自社のセキュリティ方針や、使える開発リソースに合わせて選ぶとよいでしょう。
LLMの性能はどう比べる?
LLMの性能を比べる方法として、主に以下の3つがあります。
|
ただし、スコアが高いモデルが自社の業務に最適とは限りません。実際の業務データや想定される質問で試し、回答の正確さや使い勝手を確認することが大切です。
ローカルLLMとは?
ローカルLLMとは、クラウド上のサービスを使わずに、自社のパソコンやサーバー上で動かすLLMのことです。オープンモデルをダウンロードし、手元の環境で実行する方法が一般的です。
ChatGPTなどのクラウド型サービスとは異なり、入力したデータが社外に送信されないため、セキュリティを重視する企業を中心に関心が高まっています。
ローカルLLMのメリット
ローカルLLMの主なメリットは、以下のとおりです。
|
特に、機密情報や個人情報を扱う業務でLLMを活用したい場合に、有力な選択肢になるでしょう。
ローカルLLMのデメリット
一方で、ローカルLLMには以下のようなデメリットもあります。
|
導入前に、必要な性能と運用体制を確認しておきましょう。
ローカルLLMを使うには
ローカルLLMは、専用のツールを使うと比較的かんたんに試せます。代表的なツールとして、画面上で操作できる「LM Studio」や、コマンドで操作する「Ollama」などがあります。
必要なパソコンのスペックは、動かすモデルの大きさ(パラメータ数)によって異なります。一般的に、パラメータ数が数十億程度の小型モデルであれば一般的なパソコンでも動かせる場合がありますが、大型のモデルを快適に動かすには、大容量のメモリを搭載したGPUが必要です。
クラウド型とローカル型の違いをまとめると、以下のとおりです。
|
項目 |
クラウド型LLM |
ローカルLLM |
|
データの送信先 |
サービス提供元のサーバー |
自社のパソコン・サーバー内 |
|
導入のしやすさ |
アカウントを作ればすぐに使える |
環境構築が必要 |
|
費用 |
利用量に応じた料金がかかる |
機器の購入費がかかるが、利用料はかからない |
|
回答の精度 |
最新・高性能なモデルを使える |
モデルの大きさや機器の性能に左右される |
|
運用の手間 |
少ない |
モデル更新やトラブル対応を自社で行う |
LLMでできること
LLMは言葉を扱う作業を幅広くこなせるため、さまざまな業務で活用されています。ここでは、ビジネスでの代表的な活用方法を5つ紹介します。
文章の作成・要約
メールや報告書の下書き、会議の議事録の要約などは、LLMが得意とする作業です。
たとえば、長い会議の文字起こしデータから要点を箇条書きでまとめたり、箇条書きのメモから丁寧なメール文を作成したりできます。
ゼロから文章を書く時間を短縮できるため、業務の効率化につながるでしょう。
翻訳
LLMは多言語のテキストを学習しているため、翻訳にも活用できます。
単語を置き換えるだけでなく、文脈をふまえた自然な翻訳ができる点が特徴です。「ビジネスメール向けに丁寧な表現で」といった指示を加えれば、用途に合わせた訳文を作成することもできます。
問い合わせ対応・社内ヘルプデスク
顧客からの問い合わせや、社内の「この手続きはどうすればいい?」といった質問への回答にもLLMが活用されています。
質問の意図をくみ取って回答できるため、従来のシナリオ型チャットボットよりも柔軟な対応が可能です。担当者が回答文を作成する際の下書きとして使う方法もあります。
▼あわせて読みたい
プログラムの作成
LLMは文章だけでなく、プログラムのコードも生成できます。
「この処理を行うコードを書いてほしい」と指示すればコードを提案したり、エラーの原因を説明したりできます。エンジニアの作業を補助するツールとして、開発現場でも活用が広がっています。
AIエージェントとして業務を自動化
最近では、LLMを頭脳として使い、複数の作業を自律的に進める「AIエージェント」も登場しています。
たとえば、問い合わせ内容を読み取り、社内システムで情報を確認したうえで回答を作成する、といった一連の流れを自動化できます。
▼あわせて読みたい

LLMを業務で使うときの課題
LLMは便利な一方で、仕組み上の弱点もあります。ここでは、業務で活用する際に押さえておきたい主な課題を4つ紹介します。
事実と異なる回答をすることがある
LLMは、事実とは異なる情報を、あたかも正しいかのように出力することがあります。この現象は「ハルシネーション(幻覚)」と呼ばれます。
LLMは「正しい情報を知っているから答える」のではなく、「文脈に合う言葉を予測して文章を組み立てている」ためです。文章自体は自然で正確に見えるため、内容を確認しないまま利用してしまうリスクがあります。
▼あわせて読みたい
最新情報や社内の情報を知らない
LLMは、学習した時点までのデータをもとに回答します。そのため、学習した後に起きた出来事や、更新された情報には対応できない場合があります。
また、社内規程や自社製品の仕様、顧客対応のルールといった社内の情報は、一般公開されていないため学習データに含まれていません。そのまま質問しても、自社の状況に合った回答は得られないでしょう。
情報漏えいのリスクがある
クラウド型のLLMサービスでは、入力した内容がサービス提供元のサーバーに送信されます。サービスや設定によっては、入力内容がモデルの学習に利用される場合もあります。
機密情報や個人情報を入力する前に、利用するサービスの規約やデータの取り扱いを確認することが大切です。
▼あわせて読みたい
回答の根拠がわかりにくい
LLMは、どの情報をもとに回答を生成したのかを示さない場合があります。
根拠がわからないと、回答が正しいかどうかを確認するのに手間がかかります。顧客への回答や社内の意思決定など、正確さが求められる場面では特に注意が必要です。
LLMの弱点を補う「RAG」と「ファインチューニング」
前章で紹介した課題のうち、社内の情報を知らない、回答の根拠がわかりにくいといった弱点を補う方法として、「RAG」と「ファインチューニング」があります。ここでは、それぞれの特徴と使い分けを紹介します。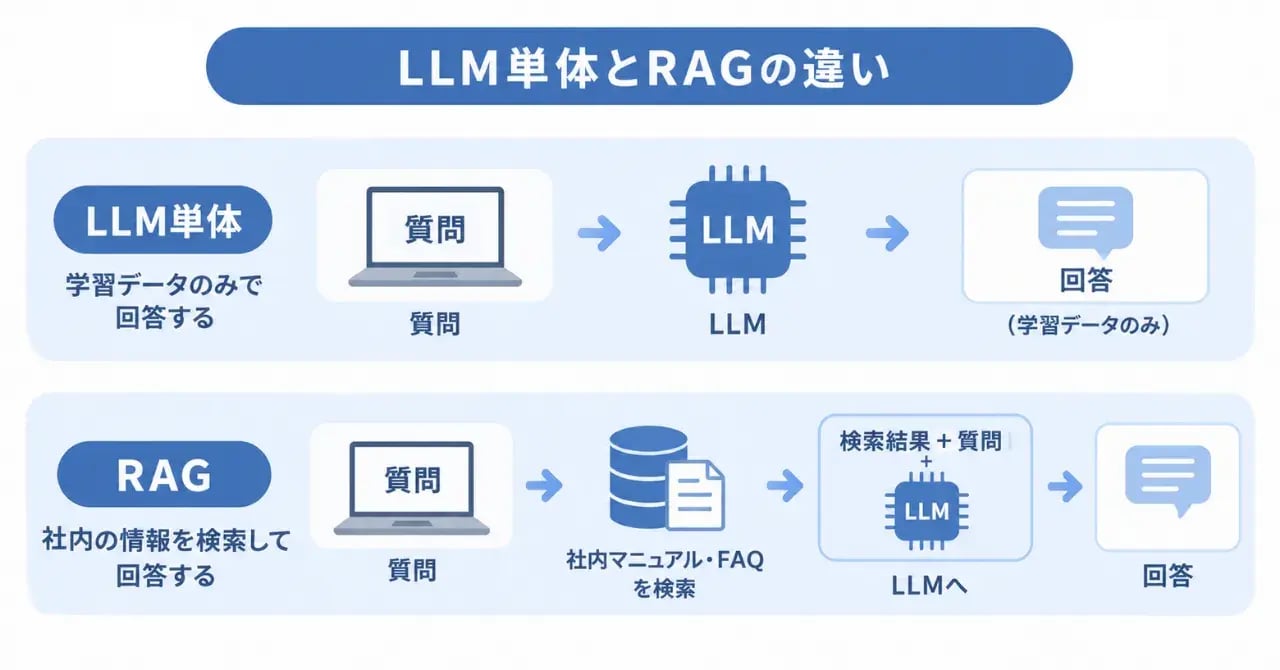
RAG(検索拡張生成)とは
RAG(Retrieval-Augmented Generation:検索拡張生成)とは、LLMが回答を生成する前に、社内文書やデータベースなどから関連する情報を検索し、その内容をもとに回答する仕組みです。
LLMが学習していない社内の情報や最新の情報も、参照先に登録しておけば回答に反映できます。また、どの文書を参照したかを示せるため、回答の根拠を確認しやすくなる点も特徴です。
ファインチューニングとは
ファインチューニングとは、学習済みのLLMに追加のデータを学習させ、特定の用途や分野に合わせてモデル自体を調整する方法です。
たとえば、自社の文章スタイルや業界特有の専門用語に合わせた回答をさせたい場合に活用されます。ただし、学習用のデータ準備や計算資源が必要になるため、コストや時間がかかる傾向があります。
RAGとファインチューニングの使い分け
RAGとファインチューニングは、目的に応じて使い分けることが大切です。それぞれの特徴を比較すると、以下のとおりです。
|
比較項目 |
RAG |
ファインチューニング |
|
仕組み |
外部の情報を検索して回答に使う |
モデル自体に追加学習させる |
|
情報の更新 |
参照先の文書を更新すればすぐに反映できる |
反映するには再学習が必要 |
|
回答の根拠 |
参照した文書を示しやすい |
示しにくい |
|
コスト |
比較的抑えやすい |
データ準備や学習にコストがかかる |
|
向いている用途 |
社内規程・製品情報・FAQなど、頻繁に更新される情報をもとにした回答 |
文章のトーンや専門用語の使い方など、回答のスタイルの調整 |
社内の情報をもとに正確に回答させたい場合は、情報を更新しやすく根拠も示しやすいRAGが現実的な選択肢といえるでしょう。
RAGの精度は「参照するナレッジの質」で決まる
RAGを導入すれば、すべての回答が正確になるわけではありません。RAGは参照した情報をもとに回答を生成するため、参照先のナレッジが古かったり、内容が重複・矛盾していたりすると、誤った回答につながります。
また、利用者の質問と文書の表現が異なる場合、必要な情報をうまく検索できないこともあります。たとえば、利用者が「パスワードを忘れた」と質問しても、マニュアルに「ログイン情報の再設定」としか書かれていなければ、該当する情報が見つからない可能性があります。
つまり、RAGの精度を高めるには、LLMやRAGの仕組みだけでなく、参照するナレッジを正確で検索しやすい状態に整えておくことが重要です。
▼あわせて読みたい
LLMを業務で活用する際のポイント
LLMを業務で効果的に活用するには、ツールを導入するだけでなく、使い方のルールや環境を整えておく必要があります。ここでは、押さえておきたい4つのポイントを紹介します。
ポイント1|目的と使う範囲を決める
まずは、どの業務の、どの作業にLLMを使うのかを明確にしましょう。
たとえば、「問い合わせへの回答文の下書き」「議事録の要約」など、具体的な作業単位で決めておくと、効果を測りやすくなります。最初から対象を広げすぎず、効果が出やすい業務から小さく始めるのがおすすめです。
ポイント2|入力してよい情報のルールを作る
情報漏えいを防ぐため、LLMに入力してよい情報と、入力してはいけない情報を社内で決めておくことが大切です。
たとえば、「顧客の個人情報は入力しない」「社外秘の資料は社内専用の環境でのみ扱う」といったルールが考えられます。利用するサービスのデータの取り扱いもあわせて確認しておきましょう。
ポイント3|AIの回答を人が確認するフローを設ける
LLMの回答には誤りが含まれる可能性があるため、そのまま利用せず、人が内容を確認する仕組みを設けましょう。
特に、顧客への回答や社外に公開する文章、法律・金額に関わる情報などは、担当者が内容を確認してから利用することが重要です。
ポイント4|AIが参照するナレッジを整備する
RAGなどを使って社内情報をもとに回答させる場合は、AIが参照するマニュアルやFAQなどのナレッジを整備しておくことが欠かせません。
古い情報を更新する、重複している内容をまとめる、担当者を決めて定期的に見直すなど、継続的に管理する体制を整えることで、AIの回答の正確さを保ちやすくなるでしょう。
よくある質問
Q. LLMとは簡単に言うと何ですか?
LLMとは、大量の文章を学習し、次にどのような言葉が続くかを予測することで、人間のように自然な文章を作れるAIです。ChatGPTやGeminiなど、多くのAIチャットサービスの土台として使われています。
Q. LLMとChatGPTの違いは何ですか?
LLMはAIモデル(技術)、ChatGPTはLLMを使って作られたサービスです。ChatGPTは、OpenAIが開発したLLM「GPT」シリーズを使い、誰でもチャット形式で利用できるようにしたものです。
つまり、LLMは「エンジン」、ChatGPTはそのエンジンを搭載した「製品」と考えるとわかりやすいでしょう。
Q. LLMとRAGの違いは何ですか?
LLMは文章を理解・生成するAIモデルそのもの、RAGはLLMに外部の情報を検索させてから回答させる仕組みです。RAGはLLMと組み合わせて使う技術であり、LLMが学習していない社内情報や最新情報をもとに回答できるようになります。
ただし、回答の正確さは参照する情報の質に左右されるため、参照先のナレッジを整備しておくことが重要です。
Q. ローカルLLMを動かすにはどのくらいのスペックが必要ですか?
動かすモデルの大きさによって異なります。小型のモデルであれば一般的なパソコンでも動かせる場合がありますが、大型のモデルを快適に動かすには、大容量のメモリを搭載したGPUが必要です。
まずは小型のモデルで試し、業務に必要な精度と処理速度を確認したうえで、機器の構成を検討するとよいでしょう。
LLMを業務で活かすなら、正確なナレッジ基盤をHelpfeelで整えましょう

LLMを業務で活用するうえで、回答の正確さを大きく左右するのが、AIが参照するナレッジの質です。LLMは参照した情報をもとに回答を生成するため、正確で整理されたナレッジを用意することが、誤回答の防止につながります。
Helpfeelは、社内に蓄積されたFAQやマニュアル、問い合わせ履歴を整理・管理し、AIが正確な情報を参照できる環境を整えるAIナレッジプラットフォームです。
Helpfeel独自のRAG技術を採用した「意図予測検索3」により、表現が異なる質問や曖昧な問いかけにも、関連する情報を的確に引き出せます。原文をもとに正確な情報を抜き出す仕組みのため、ハルシネーションを抑えながら回答できる点が特徴です。
Helpfeelは、チャネルや用途に合わせて、次のような製品を組み合わせて使えるのが特長です。
- Helpfeel FAQ:お客様向け・社内向けに使える、検索ヒット率98%のAI検索型ヘルプサイト
- Helpfeel Agent Mode:社内ドキュメントやWebの情報をもとに、チャットでAIが回答する対話型AIエージェント
- Helpfeel Analytics:問い合わせデータをAIで分析し、どのチャネルでどのような疑問が多いか、どの回答が足りないかを見える化する問い合わせ分析ツール
- Helpfeel Voice Agent:コールセンターの電話にAIが応答し、応答率と解決率を高める音声対応エージェント
- Helpfeel Call Assist:オペレーターの応対中に必要な情報を出し、新人でもベテラン並みの対応を支えるオペレーター支援エージェント
どの製品も同じナレッジをもとに回答するため、情報を更新すればすべてのチャネルにすぐ反映されます。分析結果をもとにナレッジを改善し続けることで、カスタマーサポート全体の効率化につながるでしょう。
導入後は専任のサポートチームによる運用支援も受けられるため、はじめてナレッジ基盤を整備する企業でも安心して進められます。導入実績は1000サイト以上、検索ヒット率98%を実現しており、カスタマーサポートの効率化を多くの企業で支援してきた実績があります。
LLMを業務で活用するためのナレッジ基盤づくりを検討している方は、ぜひHelpfeelをご覧ください。

まとめ
LLM(大規模言語モデル)とは、膨大なテキストデータを学習し、人間のように自然な文章を理解・生成できるAIモデルです。ChatGPTやCopilotなど、多くの生成AIサービスの土台として使われています。
この記事のポイントを振り返ります。
- LLMはAI・生成AIの一種で、ChatGPTなどはLLMを使ったサービス
- 文章をトークン化・ベクトル化し、文脈をふまえて次の言葉を予測する仕組み
- 海外・国産のモデルや、自社環境で動かせるローカルLLMなど、さまざまな種類がある
- ハルシネーションや社内情報を知らないといった課題がある
- RAGを活用すれば、社内の情報をもとに回答させられる
LLMは万能ではありませんが、得意・不得意を理解した使い分けと参照するナレッジの品質管理を組み合わせることで、業務のリスクを抑えながら効果的に活用できます。